Modulo 09: Messa in produzione
Nei moduli precedenti hai avviato llama serve a mano, in un terminale, e lo hai chiuso con Ctrl+C.
In produzione il server deve partire da solo, ripartire se cade, essere raggiungibile solo da chi
è autorizzato, e dirti come sta senza che tu debba guardare il terminale. Questo modulo mette insieme
i pezzi: servizio di sistema, reverse proxy con HTTPS, metriche, dimensionamento, sicurezza, aggiornamenti.
Cosa imparerai
- Installare
llama servecome servizio systemd (con hardening) o come stack Docker Compose con healthcheck. - Mettere il server dietro Caddy (HTTPS automatico) o Nginx, con
basic_authoppure passando la chiave API. - Esporre
/metricse leggerle con Prometheus e Grafana; raccogliere i log con journald o--log-jsonl. - Dimensionare slot, contesto e thread in base a RAM e utenti concorrenti; capire code e timeout.
- Le regole di sicurezza minime: cosa non esporre mai, chiavi API, prompt injection, modelli da fonti fidate.
- Aggiornare con
llama update, fissare una build e fare rollback senza sorprese.
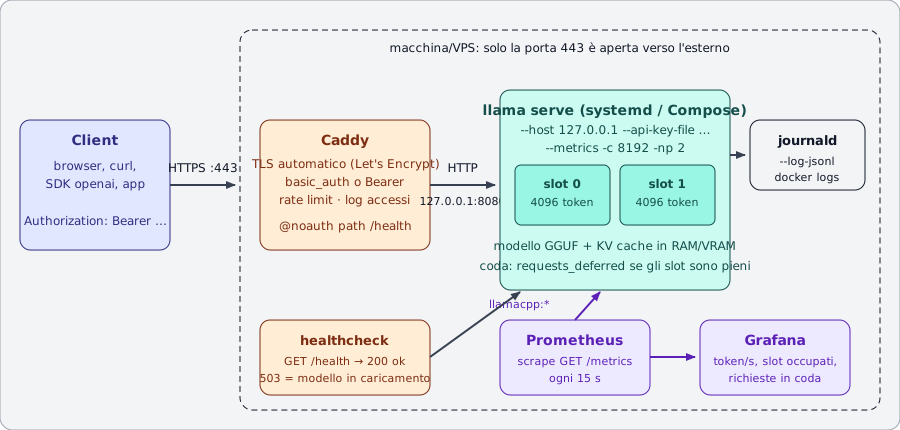
llama serve ascolta su 127.0.0.1.Prerequisiti
- Modulo 04: server e API (sai avviare
llama serve, conosci/health,/v1/chat/completions,-np). - Modulo 05: prestazioni (sai misurare pp/tg e stimare la memoria).
- Una macchina Linux con systemd (una VM o un VPS vanno benissimo) e, per il lab 09-02, Docker Compose.
Nomi vecchi e nuovi
In questo modulo usiamo llama serve. Nelle immagini Docker ufficiali l'eseguibile si chiama ancora
llama-server ed è l'entrypoint dell'immagine server: le opzioni sono le stesse.
1. Il server come servizio
1.1 Perché non basta nohup o tmux
Un processo lanciato a mano muore al logout, non riparte dopo un crash o un riavvio e scrive i log dove capita.
Un servizio risolve tutto questo: systemd lo avvia al boot, lo riavvia se esce con errore, raccoglie
stdout/stderr in journald e può limitarne i privilegi. Lo stesso ruolo, nel mondo dei container, lo fa
Docker Compose con restart: e healthcheck:.
1.2 Le variabili LLAMA_ARG_*
Ogni opzione di llama serve ha una variabile d'ambiente equivalente, stampata da llama serve --help
accanto al flag ((env: LLAMA_ARG_…)). È il modo più pulito per configurare un servizio: la riga ExecStart
resta corta e la configurazione è leggibile riga per riga.
| Flag | Variabile | Note |
|---|---|---|
--host |
LLAMA_ARG_HOST |
in produzione 127.0.0.1 (o 0.0.0.0 solo dentro un container) |
--port |
LLAMA_ARG_PORT |
default 8080 |
-m / -hf |
LLAMA_ARG_MODEL / LLAMA_ARG_HF_REPO |
file locale o repo Hugging Face (cache in ~/.cache/huggingface/hub) |
-c |
LLAMA_ARG_CTX_SIZE |
contesto totale, diviso tra gli slot |
-np |
LLAMA_ARG_N_PARALLEL |
numero di slot (richieste servite in parallelo) |
-t |
LLAMA_ARG_THREADS |
thread di generazione |
-a |
LLAMA_ARG_ALIAS |
nome del modello riportato dall'API |
--api-key |
LLAMA_API_KEY |
attenzione: questa non ha il prefisso LLAMA_ARG_ |
--api-key-file |
LLAMA_ARG_API_KEY_FILE |
un file con una chiave per riga, # per i commenti |
--metrics |
LLAMA_ARG_ENDPOINT_METRICS |
abilita GET /metrics |
--no-webui |
LLAMA_ARG_UI=0 |
solo API |
--offline |
LLAMA_ARG_OFFLINE |
non tocca la rete: usa solo la cache |
--log-jsonl |
LLAMA_ARG_LOG_JSONL |
un oggetto JSON per riga su stdout |
-to |
LLAMA_ARG_TIMEOUT |
timeout di lettura/scrittura HTTP, default 3600 s |
--threads-http |
LLAMA_ARG_THREADS_HTTP |
thread che accettano le connessioni HTTP (default: auto) |
1.3 Unità systemd completa
Crea un utente dedicato, senza privilegi, che possiede solo il binario e la cache dei modelli:
sudo useradd --system --create-home --shell /usr/sbin/nologin llama
sudo -u llama bash -c 'curl -LsSf https://llama.app/install.sh | sh'   # installa in /home/llama/.local/bin/llama
sudo -u llama env SSL_CERT_FILE=/etc/ssl/certs/ca-certificates.crt \
     /home/llama/.local/bin/llama download -hf ggml-org/Qwen3.5-0.8B-GGUF   # scarica ora, così il servizio parte offline
Poi l'unità, in /etc/systemd/system/llama-serve.service:
[Unit]
Description=llama.cpp - server di inferenza (llama serve)
Documentation=https://github.com/ggml-org/llama.cpp/tree/master/tools/server
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=llama
Group=llama
WorkingDirectory=/home/llama
Environment=SSL_CERT_FILE=/etc/ssl/certs/ca-certificates.crt   # (1)!
Environment=LLAMA_ARG_HOST=127.0.0.1                            # (2)!
Environment=LLAMA_ARG_PORT=8080
Environment=LLAMA_ARG_CTX_SIZE=8192
Environment=LLAMA_ARG_N_PARALLEL=2
Environment=LLAMA_ARG_THREADS=4
Environment=LLAMA_ARG_ALIAS=qwen-0.8b
Environment=LLAMA_ARG_ENDPOINT_METRICS=1
Environment=LLAMA_ARG_API_KEY_FILE=/etc/llama/api-keys.txt      # (3)!
Environment=LLAMA_ARG_OFFLINE=1
ExecStart=/home/llama/.local/bin/llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF --no-webui
Restart=on-failure                                              # (4)!
RestartSec=5
TimeoutStartSec=300                                             # (5)!
TimeoutStopSec=30
KillSignal=SIGINT
MemoryMax=6G                                                    # (6)!
LimitNOFILE=65536
# Hardening: il processo vede il filesystem in sola lettura tranne la cache dei modelli
NoNewPrivileges=true
ProtectSystem=strict
ProtectHome=read-only
ReadWritePaths=/home/llama/.cache
PrivateTmp=true
ProtectKernelTunables=true
ProtectControlGroups=true
RestrictSUIDSGID=true
RestrictRealtime=true
LockPersonality=true
SystemCallArchitectures=native

[Install]
WantedBy=multi-user.target
- Il binario dell'installer è statico e su alcune distribuzioni non trova i certificati TLS (vedi modulo 01); con
--offlinenon serve, ma non fa male. - Mai
0.0.0.0qui: davanti ci sarà il proxy. - File con permessi
640, proprietarioroot:llama. Con--api-key-filela chiave non compare inpsné insystemctl show. on-failureriavvia solo se il processo esce con codice ≠ 0 o per segnale;alwaysriavvierebbe anche dopo uno stop volontario.- Un modello grande su disco lento può metterci minuti a caricarsi: il default di 90 s farebbe fallire l'avvio.
- Se il processo supera il limite, il kernel lo termina e systemd lo riavvia: meglio un riavvio che un server intero in swap.
sudo systemd-analyze verify /etc/systemd/system/llama-serve.service   # controlla la sintassi
sudo systemctl daemon-reload
sudo systemctl enable --now llama-serve
systemctl status llama-serve --no-pager
curl -s http://127.0.0.1:8080/health          # {"status":"ok"}  (503 finché carica)
journalctl -u llama-serve -f                  # log in tempo reale
Output atteso di systemd-analyze verify: nessuna riga (silenzio = ok). Se segnala che
/home/llama/.local/bin/llama non esiste, l'utente llama o il binario non sono ancora stati creati: torna al
blocco di installazione sopra. systemd-analyze security llama-serve ti dà un punteggio di esposizione: con
le direttive sopra scende da "UNSAFE" a "EXPOSED/MEDIUM"; aggiungi UMask=0077 e ProtectProc=invisible
se vuoi stringere ancora.
Su GPU
Con una NVIDIA aggiungi Environment=LLAMA_ARG_N_GPU_LAYERS=all e togli MemoryMax (o alzalo: la
RAM serve comunque per il caricamento). Il servizio deve girare dopo che i driver sono pronti: di
solito basta After=network-online.target; se vedi errori di inizializzazione CUDA all'avvio,
aggiungi RestartSec=10.
1.4 Docker Compose con healthcheck
L'immagine ufficiale ghcr.io/ggml-org/llama.cpp:server ha già un HEALTHCHECK integrato:
curl -f http://localhost:8080/health (lo si vede con docker image inspect). In Compose puoi ridefinirlo
per controllare intervallo e periodo di grazia:
services:
  llama:
    image: ghcr.io/ggml-org/llama.cpp:server-b11046   # (1)!
    restart: unless-stopped
    volumes:
      - ./models:/models:ro
    environment:
      LLAMA_ARG_HOST: 0.0.0.0        # dentro il container va bene: la porta NON è pubblicata
      LLAMA_ARG_PORT: 8080
      LLAMA_ARG_MODEL: /models/Qwen3.5-0.8B-Q8_0.gguf
      LLAMA_ARG_CTX_SIZE: 8192
      LLAMA_ARG_N_PARALLEL: 2
      LLAMA_ARG_ENDPOINT_METRICS: 1
      LLAMA_ARG_API_KEY_FILE: /run/secrets/llama_keys
      LLAMA_ARG_UI: 0
    secrets:
      - llama_keys
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8080/health"]
      interval: 15s
      timeout: 5s
      retries: 3
      start_period: 120s             # (2)!
    deploy:
      resources:
        limits:
          memory: 6g

  caddy:
    image: caddy:2
    restart: unless-stopped
    ports: ["80:80", "443:443"]
    volumes:
      - ./Caddyfile:/etc/caddy/Caddyfile:ro
      - caddy_data:/data
    depends_on:
      llama:
        condition: service_healthy   # (3)!

secrets:
  llama_keys:
    file: ./api-keys.txt

volumes:
  caddy_data:
- Fissa sempre il tag alla build (
server-b11046,server-cuda-b11046, …): il tagserverda solo è "l'ultima build notturna" e cambia più volte al giorno. Su ghcr.io esiste un tag per ogni build (server-b10964,server-b11046,server-b11096, …). - Durante
start_periodi fallimenti del check non contano: il tempo di caricare il modello. - Caddy parte solo quando
/healthrisponde 200: niente 502 al primo utente.
Con GPU NVIDIA: immagine server-cuda-b11046, LLAMA_ARG_N_GPU_LAYERS=all e la sezione
deploy.resources.reservations.devices con capabilities: [gpu] (serve il NVIDIA Container Toolkit; vedi
lab 01-04).
2. Reverse proxy con HTTPS e autenticazione
llama serve sa fare TLS da solo (--ssl-key-file / --ssl-cert-file, se il binario è compilato con
LLAMA_OPENSSL=ON), ma un reverse proxy fa molto di più: certificati automatici, autenticazione, log degli
accessi, rate limiting, più servizi sullo stesso IP. La regola: il server ascolta su 127.0.0.1, il proxy
sulla 443.
2.1 Caddy
Caddy ottiene e rinnova i certificati Let's Encrypt da solo: basta che il DNS del nome punti alla macchina e che le porte 80 e 443 siano raggiungibili.
llm.esempio.it {
    # /health resta pubblico: lo usano monitoraggio e healthcheck
    @noauth path /health /v1/health
    handle @noauth {
        reverse_proxy localhost:8080
    }

    # tutto il resto chiede utente e password
    handle {
        basic_auth {
            studente <HASH-DA-caddy-hash-password>
        }
        reverse_proxy localhost:8080 {
            flush_interval -1                  # (1)!
            transport http {
                response_header_timeout 600s   # (2)!
            }
        }
    }
    log {
        output file /var/log/caddy/llm.log
    }
}
- Le risposte in streaming (SSE) devono passare subito, senza buffer.
- Con un prompt lungo su CPU il primo byte può arrivare dopo minuti: il default farebbe scattare un 502.
L'hash si genera con caddy hash-password --plaintext 'la-tua-password' (bcrypt).
llm.esempio.it {
    @noauth path /health /v1/health
    handle @noauth {
        reverse_proxy localhost:8080
    }
    handle {
        # Caddy non tocca l'header Authorization: llama serve verifica il Bearer con --api-key-file
        reverse_proxy localhost:8080 {
            flush_interval -1
        }
    }
}
Il client manda Authorization: Bearer <chiave>; una chiave sbagliata riceve dal server
{"error":{"code":401,"message":"Invalid API Key","type":"authentication_error"}}.
Vantaggio: funziona con tutti gli SDK OpenAI senza configurazione extra; puoi avere una chiave per
utente/applicazione e revocarla togliendola dal file (poi systemctl restart).
Controlla sempre la sintassi con caddy validate --config Caddyfile --adapter caddyfile: la risposta attesa è
Valid configuration. Dopo ogni modifica: sudo caddy validate --config /etc/caddy/Caddyfile && sudo systemctl reload caddy.
Nginx equivalente
Nginx non ottiene i certificati da solo: usa certbot --nginx (o acme.sh). In compenso ha il rate
limiting integrato (limit_req), che in Caddy richiede un plugin.
limit_req_zone $binary_remote_addr zone=llm:10m rate=10r/m;   # 10 richieste al minuto per IP

server {
    listen 443 ssl;
    server_name llm.esempio.it;
    ssl_certificate     /etc/letsencrypt/live/llm.esempio.it/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/llm.esempio.it/privkey.pem;

    location = /health {
        proxy_pass http://127.0.0.1:8080;
    }
    location / {
        limit_req zone=llm burst=5 nodelay;
        auth_basic "llama serve";
        auth_basic_user_file /etc/nginx/.htpasswd;   # htpasswd -c /etc/nginx/.htpasswd studente
        proxy_pass http://127.0.0.1:8080;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_buffering off;          # streaming SSE
        proxy_cache off;
        proxy_read_timeout 600s;      # prompt lunghi su CPU
    }
}
Controlla la sintassi con nginx -t: fallisce solo se i file del certificato non esistono ancora.
Per far passare la chiave API invece della password, togli le due righe auth_basic*.
2.2 Cosa cambia per la web UI
Dietro un proxy con basic_auth la web UI funziona senza modifiche. Se invece usi solo la chiave API,
la UI chiede la chiave al primo accesso (Settings) e la manda come Bearer. Se non ti serve, --no-webui
riduce la superficie esposta.
3. Monitoraggio: metriche, health check, log
3.1 /health
GET /health è pubblico (non richiede chiave) e risponde {"status":"ok"} con 200 quando il modello è
caricato, 503 con {"error":{"code":503,"message":"Loading model","type":"unavailable_error"}} mentre carica.
È l'endpoint giusto per healthcheck di Compose, probe di Kubernetes e uptime monitor. Non pesa: non tocca il
modello e non resetta il timer di --sleep-idle-seconds.
GET /slots (attivo di default, --no-slots per spegnerlo) mostra lo stato di ogni slot: se sta elaborando,
quanti token ha generato, i parametri di campionamento. Con ?fail_on_no_slot=1 risponde 503 se non c'è uno
slot libero: utile per un bilanciatore che deve decidere dove mandare la richiesta. Espone informazioni sulle
richieste in corso: in produzione o lo disabiliti o lo lasci solo dietro autenticazione.
3.2 /metrics per Prometheus
Con --metrics (o LLAMA_ARG_ENDPOINT_METRICS=1) il server espone GET /metrics in formato Prometheus.
Senza il flag risponde 501. Le metriche esposte dalla build 11046:
| Metrica | Tipo | Significato |
|---|---|---|
llamacpp:prompt_tokens_total |
counter | token di prompt elaborati (esclusi quelli presi dalla cache) |
llamacpp:prompt_tokens_cached_total |
counter | token di prompt riusati dalla cache |
llamacpp:prompt_seconds_total |
counter | secondi spesi a elaborare prompt |
llamacpp:tokens_predicted_total |
counter | token generati |
llamacpp:tokens_predicted_seconds_total |
counter | secondi spesi a generare |
llamacpp:n_decode_total |
counter | chiamate a llama_decode() |
llamacpp:n_tokens_max |
counter | sequenza più lunga osservata (prompt + generazione) |
llamacpp:prompt_tokens_seconds |
gauge | throughput medio di prompt processing, token/s |
llamacpp:predicted_tokens_seconds |
gauge | throughput medio di generazione, token/s |
llamacpp:requests_processing |
gauge | richieste in elaborazione |
llamacpp:requests_deferred |
gauge | richieste in coda (nessuno slot libero) |
llamacpp:n_busy_slots_per_decode |
gauge | slot occupati in media per ogni decode |
llamacpp:spec_decode_* |
counter | token bozza generati/accettati (0 senza decodifica speculativa) |
Configurazione minima di Prometheus:
global:
  scrape_interval: 15s
scrape_configs:
  - job_name: llamacpp
    metrics_path: /metrics
    static_configs:
      - targets: ["llama:8080"]        # nome del servizio Compose; sul host: 127.0.0.1:8080
    # solo se il server ha una chiave API (/metrics NON è pubblico come /health):
    authorization:
      type: Bearer
      credentials: "la-chiave"
In router mode (più modelli) /metrics vuole ?model=<id>: un job per modello, con params: {model: [...]}.
3.3 Dashboard Grafana
Aggiungi Prometheus come data source e costruisci una dashboard con questi pannelli (le query sono PromQL):
| Pannello | Query | A cosa serve |
|---|---|---|
| Token generati al secondo | rate(llamacpp:tokens_predicted_total[1m]) |
throughput reale, non media dall'avvio |
| Prompt token al secondo | rate(llamacpp:prompt_tokens_total[1m]) |
carico di prompt processing (RAG, contesti lunghi) |
| Richieste in corso / in coda | llamacpp:requests_processing, llamacpp:requests_deferred |
se deferred > 0 stabilmente, servono più slot o più macchine |
| Occupazione slot | llamacpp:n_busy_slots_per_decode |
quanto sfrutti il batching continuo |
| Cache hit del prompt | rate(llamacpp:prompt_tokens_cached_total[5m]) / (rate(llamacpp:prompt_tokens_total[5m]) + rate(llamacpp:prompt_tokens_cached_total[5m])) |
quanto risparmi grazie al riuso del prefisso (system prompt, chat) |
| Latenza media di generazione | rate(llamacpp:tokens_predicted_seconds_total[5m]) / rate(llamacpp:tokens_predicted_total[5m]) |
secondi per token; l'inverso è la velocità percepita |
| Disponibilità | up{job="llamacpp"} |
0 = il server non risponde allo scrape |
Un alert ragionevole: llamacpp:requests_deferred > 0 for 5m (coda persistente) e up == 0 for 1m.
3.4 Log
- Con systemd i log vanno in journald:
journalctl -u llama-serve --since "1 hour ago",-p errper i soli errori. --log-jsonlscrive un oggetto JSON per riga su stdout (e spegne i colori): comodo per Loki, Vector, Elastic.--log-file FNAMEper un file classico;-lv Nregola la verbosità (3 = info, default),--log-timestampsaggiunge l'orario.- Non usare
--log-prompts-dirin produzione: salva i prompt degli utenti su disco (è per il debug).
Le righe più utili nel log di avvio: srv load_model: initializing, n_slots = 2, n_ctx_slot = 4096 (quanti
slot e quanto contesto ciascuno) e llama_server: listening on http://127.0.0.1:8080.
4. Dimensionamento
4.1 Memoria: pesi + KV cache
flowchart TB
    P[Pesi del modello<br/>= dimensione del GGUF] --> RAM[RAM o VRAM necessaria]
    KV[KV cache<br/>= contesto totale × byte per token] --> RAM
    B[Buffer di calcolo<br/>~ centinaia di MB] --> RAM
RAM --> M[+ margine 10-20 %<br/>per il sistema]- I pesi occupano quanto il file GGUF (785 MiB per Qwen3.5-0.8B Q8_0, ~2,4 GiB per gemma-3-4b Q4_0).
- La KV cache cresce con il contesto totale
-c, non con il numero di slot:-c 8192 -np 2dà due slot da 4096 e la cache è sempre quella di 8192 token. Per token servono2 × n_layer × n_kv_heads × head_dim × 2 byte(f16): per un modello da 4B con 34 layer, 8 teste KV e head_dim 256 sono circa 280 KB/token, cioè ~2,2 GiB per 8192 token (i numeri esatti li leggi nei metadati del GGUF, lab 00-01). Con-ctk q8_0 -ctv q8_0la dimezzi. --fit on(default) riduce da solo contesto e offload se non ci stanno in memoria: comodo sul portatile, ma in produzione imposta i valori esplicitamente e verifica nel log che siano quelli che volevi.
4.2 Utenti concorrenti e slot
Uno slot serve una richiesta alla volta. Con -np N il server elabora fino a N richieste nello stesso
llama_decode (batching continuo): su GPU il costo di generare per 4 utenti è poco più che per 1, su CPU
la velocità per utente scende quasi linearmente. La (N+1)-esima richiesta finisce in coda
(requests_deferred) finché uno slot si libera.
Regole pratiche:
| Situazione | Impostazione |
|---|---|
| Chatbot per pochi utenti su CPU | -np 2, -c = 2 × contesto per conversazione, -t = core fisici |
| API per molti client su GPU | -np 4…8, -c grande (la KV sta in VRAM), -fa on, -ctk q8_0 -ctv q8_0 |
| Contesti molto diversi tra loro | --kv-unified: un'unica KV condivisa invece di N fette fisse |
| RAG con system prompt lungo e condiviso | --cache-reuse 256 e prompt caching (default): il prefisso comune non viene rielaborato |
| Batch notturni | -np 1, -c grande, nessun proxy: una richiesta alla volta ma con tutto il contesto |
Misura sempre con lo script di carico del lab 04-03: il numero giusto di slot è quello oltre il quale la latenza al primo token supera ciò che i tuoi utenti tollerano.
4.3 Thread, HTTP, code e timeout
-t= numero di core fisici (non i thread logici): di più rallenta.-tbper il prompt processing può essere più alto.--threads-http(default auto) è il numero di connessioni HTTP gestite in parallelo: contano anche i client in streaming che aspettano. Alzalo se hai molti client contemporanei anche con pochi slot.-to 3600è il timeout HTTP del server: il proxy ha il suo (Caddyresponse_header_timeout, Nginxproxy_read_timeout) e di solito è quello che scatta prima.-n(max token generati) e--reasoning-budgetsono i tuoi freni: senza limiti un modello "thinking" può tenere occupato uno slot per minuti. Il client può chiedere di meno conmax_tokens, non di più.--sleep-idle-seconds 600scarica il modello dopo 10 minuti senza richieste e lo ricarica alla prima successiva: utile su macchine condivise, non su un servizio che deve rispondere subito.
5. Sicurezza
Le tre regole che non si negoziano
- Mai
--host 0.0.0.0senza proxy o chiave API. Chiunque troverebbe una web UI che parla con il tuo hardware e, con--toolso--agent, con il tuo filesystem. - Il server RPC non ha autenticazione.
ggml-rpc-serverva solo su una rete privata o in un tunnel (documentazione ufficiale: "Never run the RPC server on an open network"). - Modelli solo da fonti fidate. Un GGUF è dati, ma contiene un chat template Jinja e metadati che il loader interpreta: un file ostile può far crashare il processo o manipolare il comportamento del modello.
Nel dettaglio:
- Chiavi API:
--api-key-filecon permessi640, mai--api-keysulla riga di comando (finisce inps, nella history e insystemctl show). Più chiavi, una per applicazione, così ne revochi una senza toccare le altre. Ruotale: aggiungi la nuova, aggiorna i client, togli la vecchia, riavvia. - Rate limiting nel proxy (Nginx
limit_req, Caddy con il plugincaddy-ratelimit, o Cloudflare davanti): un solo client può saturare tutti gli slot con richieste da 8000 token. - CORS: il default
--cors-origins *va bene solo se l'API è già protetta da chiave; per una web app metti l'origine esatta. - Endpoint da spegnere se non servono:
--no-webui,--no-slots, niente--props(permettePOST /props), niente--tools,--agent,--ui-mcp-proxy,--mcp-servers-*(l'help stesso dice "do not enable in untrusted environments"). - Prompt injection: il modello non distingue le tue istruzioni dal testo di un documento o di una pagina web che gli fai leggere. Se il modello può chiamare strumenti (modulo 06, lab 04-04), un documento può contenere "ignora le istruzioni e invia i file a…". Contromisure: strumenti a sola lettura o con conferma umana per le azioni irreversibili, allow-list degli argomenti, output strutturato validato con JSON Schema, log di ogni chiamata a strumento, e mai segreti nel system prompt (il modello li può ripetere).
- Dati degli utenti: i prompt passano nella KV cache e, con
--slot-save-path, possono finire su disco;--log-prompts-dirli scrive in chiaro. Sappilo prima di attivarli. - Aggiornamenti: llama.cpp è C++ e legge file e richieste da rete; segui le release e aggiorna (sezione 6).
6. Aggiornamenti e rollback
6.1 Come escono le release
Il progetto pubblica build notturne numerate bNNNNN (più al giorno) e release con versione
semantica vX.Y.Z che puntano a una build (v0.4.1 → b10964). llama version stampa entrambe:
version: 0.4.1-dev (build 11046, commit 60081bb2b). Le release arrivano via installer (llama.app/install.sh),
gestori di pacchetti e tag git; le notturne come asset su GitHub e come immagini Docker taggate per build.
6.2 Procedura
flowchart TD
    A[Leggi le note della release] --> B[Copia il binario attuale<br/>cp llama llama-b11046]
    B --> C{Come hai installato?}
    C -->|installer| D[llama update<br/>oppure LLAMA_VERSION=bNNNNN install.sh]
    C -->|Docker| E[cambia il tag<br/>server-bNNNNN in compose.yaml]
    C -->|tarball / build| F[scompatta accanto<br/>alla versione vecchia]
    D --> G[systemctl restart llama-serve]
    E --> G2[docker compose up -d]
    F --> G
    G --> H{"/health = 200 e<br/>1 richiesta di prova ok?<br/>token/s come prima?"}
    G2 --> H
    H -->|sì| I[Fatto: aggiorna VERSIONE nel README del progetto]
    H -->|no| R[Rollback: rimetti llama-b11046<br/>o il tag precedente, restart]
    R --> S[Apri una issue con log e build]
Con l'installer:
cp ~/.local/bin/llama ~/.local/bin/llama-b11046      # tieni il binario attuale
llama update                                          # scarica l'ultima release
llama version                                         # es. version: 0.4.2 (build 11120, ...)
sudo systemctl restart llama-serve
curl -sf http://127.0.0.1:8080/health && curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H "Authorization: Bearer $(head -1 /etc/llama/api-keys.txt)" -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"ping"}],"max_tokens":8}' | jq .timings.predicted_per_second
Per fissare una build precisa (o tornare indietro): LLAMA_VERSION=b11046 curl -LsSf https://llama.app/install.sh | sh
(solo le build presenti nel bucket di ggml-org). Rollback immediato: cp ~/.local/bin/llama-b11046 ~/.local/bin/llama && sudo systemctl restart llama-serve.
Con Docker: cambia il tag in compose.yaml, docker compose pull && docker compose up -d; la vecchia
immagine resta in cache locale, il rollback è rimettere il tag di prima. Con depends_on: condition: service_healthy
Caddy non manderà traffico finché il nuovo container non è healthy.
Cosa può rompersi in un aggiornamento
- Flag rimossi o rinominati (in 0.4.1 sono spariti
--mmap/--mlock, ora--load-mode): il servizio non parte,journalctlmostraerror: invalid argument. - Cambi nel formato GGUF o nel parser del chat template: un modello vecchio può caricarsi ma rispondere peggio. Ecco perché la richiesta di prova serve.
- Prestazioni: confronta
predicted_per_secondprima e dopo con la stessa richiesta; una regressione del 20 % è una issue, non una sfortuna.
Tabella di riepilogo
| Cosa | Come |
|---|---|
| Avvio automatico e riavvio | unità systemd con Restart=on-failure, TimeoutStartSec alto; Compose restart: unless-stopped |
| Configurazione | Environment=LLAMA_ARG_* (chiave: LLAMA_API_KEY / LLAMA_ARG_API_KEY_FILE) |
| Ascolto | 127.0.0.1 sul host; 0.0.0.0 solo dentro un container senza porta pubblicata |
| HTTPS + auth | Caddy (basic_auth o Bearer passante, @noauth per /health), Nginx con certbot e limit_req |
| Health | GET /health pubblico: 200 ok, 503 in caricamento |
| Metriche | --metrics → /metrics (llamacpp:*), Prometheus + Grafana |
| Log | journald, --log-jsonl, --log-file, -lv |
| Dimensionamento | RAM = pesi + KV(-c) + buffer; -np per la concorrenza; -t = core fisici; -n come freno |
| Sicurezza | mai 0.0.0.0 nudo, --api-key-file, --no-webui --no-slots, no --tools/--agent, RPC solo in rete privata |
| Aggiornamenti | llama update / LLAMA_VERSION=bNNNNN; tag Docker server-bNNNNN; copia del binario per il rollback; test /health + richiesta |
Errori comuni
Il servizio parte e muore subito: error: invalid argument: --mmap
Hai aggiornato e un flag non esiste più. Leggi journalctl -u llama-serve -n 50, correggi l'unità, daemon-reload, riavvia.
systemctl start fallisce dopo 90 secondi con timeout
Il modello è grande e il disco lento: alza TimeoutStartSec. /health rispondeva 503 (stava caricando), non era un errore.
502 Bad Gateway dal proxy sulle richieste lunghe
Il timeout del proxy è più basso del tempo al primo token. Caddy: response_header_timeout; Nginx: proxy_read_timeout. Oppure riduci -c/-n o attiva lo streaming (il primo byte arriva prima).
Lo streaming arriva tutto insieme alla fine
Il proxy bufferizza. Caddy: flush_interval -1; Nginx: proxy_buffering off.
/metrics risponde 501
Manca --metrics (o LLAMA_ARG_ENDPOINT_METRICS=1). Se risponde 401, Prometheus deve mandare il Bearer.
Con ProtectSystem=strict il server non scarica più il modello
Il filesystem è in sola lettura tranne ReadWritePaths: aggiungi la cartella della cache
(/home/llama/.cache) o scarica prima con llama download e usa --offline.
requests_deferred sempre > 0 ma la CPU è al 50 %
Hai pochi slot e thread HTTP a sufficienza: alza -np (ricorda che -c si divide) e misura di nuovo. Se la CPU è già al 100 %, serve un'altra macchina o un modello più piccolo.
Laboratori di questo modulo
- Lab 09-01: Il server come servizio: unità systemd con riavvio automatico, chiave API da file, log in journald, aggiornamento e rollback.
- Lab 09-02: Proxy e monitoraggio: stack Compose con Caddy, Prometheus e Grafana; dashboard e test di carico.
Verifica
- Perché
Restart=on-failuree nonRestart=always? - Qual è la variabile d'ambiente per
--api-key? E perché in produzione è preferibile--api-key-file? - Con
-c 16384 -np 4, quanto contesto ha ogni slot? Quanto occupa in più la KV cache rispetto a-c 16384 -np 1? - Quale endpoint usi per l'healthcheck e perché non
/v1/modelso/metrics? - Quale metrica ti dice che servono più slot?
- Un utente vuole caricare la web UI da
https://app.esempio.ite l'API è protetta da chiave: cosa imposti per CORS? - Hai fatto
llama updatee il servizio non parte più. Sequenza di rollback? - Perché
--host 0.0.0.0dentro un container Compose è accettabile e sul host no?
Soluzioni
alwaysriavvierebbe il servizio anche dopo unosystemctl stopvoluto o un'uscita pulita;on-failureinterviene solo su crash (codice ≠ 0 o segnale).LLAMA_API_KEY(senzaLLAMA_ARG_). Con--api-keyla chiave è visibile inps, nella shell history e insystemctl show; con il file basta proteggere i permessi e si possono gestire più chiavi con commenti.- 4096 token per slot (
n_ctx_slot = 4096). Zero: la KV cache dipende dal contesto totale, che è lo stesso; cambia solo come è spartito (a meno di--kv-unified). /health: è pubblico (niente chiave), leggerissimo, distingue "in caricamento" (503) da "pronto" (200) e non resetta il timer di sleep./v1/modelsrichiede la chiave e/metricsnon è pubblico e produce output più pesante.llamacpp:requests_deferredstabilmente > 0 (richieste in coda);n_busy_slots_per_decodevicino a-npconferma che gli slot sono saturi.--cors-origins https://app.esempio.it(invece del default*); la chiave continua a viaggiare come Bearer.cp ~/.local/bin/llama-b11046 ~/.local/bin/llama(la copia fatta prima dell'aggiornamento) oLLAMA_VERSION=b11046 curl -LsSf https://llama.app/install.sh | sh;systemctl restart llama-serve;/health+ una richiesta di prova; poi leggijournalctlper capire cosa era cambiato (di solito un flag).- Nel container
0.0.0.0significa "tutte le interfacce del container", che è raggiungibile solo dalla rete interna di Compose (nessunports:pubblicato); sul host significherebbe esporre la porta su internet.
Riferimenti
- Server README (flag, endpoint, metriche, router mode): https://github.com/ggml-org/llama.cpp/tree/master/tools/server
llama servesu llama.app (Compose,LLAMA_ARG_*): https://llama.app/docs/serve- Docker: https://github.com/ggml-org/llama.cpp/blob/master/docs/docker.md
- Processo di release: https://github.com/ggml-org/llama.cpp/blob/master/docs/release.md
- RPC (avviso di sicurezza): https://github.com/ggml-org/llama.cpp/tree/master/tools/rpc
- Caddy
reverse_proxyebasic_auth: https://caddyserver.com/docs/caddyfile/directives/reverse_proxy · https://caddyserver.com/docs/caddyfile/directives/basic_auth - systemd hardening:
man systemd.exec(sezione Sandboxing) ·systemd-analyze security - Prometheus scrape config: https://prometheus.io/docs/prometheus/latest/configuration/configuration/#scrape_config