Lab 04-03: Carico e parallelismo¶
Obiettivo¶
Misurare con uno script di carico che cosa succede quando 4 client interrogano insieme un server con
-np 1, -np 2 e -np 4: latenza della singola richiesta, throughput aggregato (token generati al secondo
sommando tutti i client), slot occupati contemporaneamente. E vedere con i tuoi occhi il prezzo del
parallelismo: il contesto -c si divide fra gli slot.
Prerequisiti¶
- Lab 04-01 (sai leggere
n_ctx_slotnel log etimingsnelle risposte). - Python 3 (solo libreria standard:
carico.pynon ha dipendenze). - Una macchina "tranquilla": chiudi browser e altri processi pesanti, i numeri dipendono dai core liberi.
Materiale¶
| Cosa | Dove | Dimensione |
|---|---|---|
ggml-org/Qwen3.5-0.8B-GGUF (file Qwen3.5-0.8B-Q8_0.gguf, Apache 2.0) |
Hugging Face, via -hf |
785 MiB |
carico.py: manda N richieste in parallelo con ThreadPoolExecutor, campiona /slots ogni 0,5 s, stampa latenze e throughput |
cartella del lab | 4 KB |
Lo script usa 8 prompt diversi (uno per richiesta) perché con lo stesso prompt la prompt cache falserebbe il
confronto, e spegne il thinking con chat_template_kwargs così i 32 token generati sono tutti di risposta.
Procedura¶
Le misure riportate vengono da una macchina a 6 vCPU senza GPU (-t 3): i valori assoluti sulla tua
macchina saranno diversi, i rapporti no.
-
Server con un solo slot:
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF --host 127.0.0.1 --port 8080 -c 2048 -np 1 -t 3 -a qwen-0.8bLog:
n_slots = 1, n_ctx_slot = 2048. Da un altro terminale:cd corso/laboratori/lab-04-03-parallelismo python3 carico.py --url http://127.0.0.1:8080 --richieste 4 --parallele 4 --token 32server: 1 slot, n_ctx per slot = 2048 req 0: 8.54 s 32 token (8.8 t/s nel proprio slot) req 1: 3.58 s 32 token (11.4 t/s nel proprio slot) req 2: 20.30 s 32 token (5.1 t/s nel proprio slot) req 3: 13.46 s 32 token (7.8 t/s nel proprio slot) richieste=4 parallele=4 slot=1 picco slot occupati insieme=1 tempo totale 20.31 s | latenza media 11.47 s, max 20.30 s throughput aggregato 6.30 token/s (128 token generati)Le 4 richieste arrivano insieme ma c'è un solo slot: vengono servite una alla volta (
picco slot occupati = 1). Ogni richiesta, quando tocca a lei, genera a 5-11 t/s, ma l'ultima ha aspettato in coda 17 s. Il tempo totale è la somma delle quattro. (llamacpp:requests_deferredin/metricsconta proprio queste attese.) -
Due slot. Ferma il server con Ctrl+C e riavvialo con
-np 2(tutto il resto uguale), poi ripeti il test:server: 2 slot, n_ctx per slot = 1024 req 0: 14.08 s 32 token (3.0 t/s nel proprio slot) req 1: 12.89 s 31 token (3.2 t/s nel proprio slot) req 2: 22.28 s 32 token (3.8 t/s nel proprio slot) req 3: 22.70 s 32 token (4.1 t/s nel proprio slot) richieste=4 parallele=4 slot=2 picco slot occupati insieme=2 tempo totale 22.76 s | latenza media 17.99 s, max 22.70 s throughput aggregato 5.58 token/s (127 token generati)Due richieste avanzano insieme (
picco = 2), le altre due aspettano. Nota che la velocità per slot è scesa (3-4 t/s contro 5-11): su CPU i core sono già saturi con una sequenza, quindi far avanzare due sequenze a ognillama_decodecosta quasi il doppio per passo. Qui il totale è sceso: con i core già saturi due slot non rendono più di uno. Una misura di throughput su CPU va ripetuta due o tre volte e mediata prima di trarre conclusioni. -
Quattro slot. Riavvia con
-np 4:server: 4 slot, n_ctx per slot = 512 req 0: 10.12 s 32 token (4.0 t/s nel proprio slot) req 1: 10.28 s 32 token (4.3 t/s nel proprio slot) req 2: 10.28 s 32 token (4.3 t/s nel proprio slot) req 3: 10.27 s 32 token (4.3 t/s nel proprio slot) richieste=4 parallele=4 slot=4 picco slot occupati insieme=4 tempo totale 10.30 s | latenza media 10.24 s, max 10.28 s throughput aggregato 12.42 token/s (128 token generati)Ora le quattro richieste partono e finiscono insieme (latenze quasi identiche, nessuna coda): il batching continuo le fa avanzare tutte a ogni passo. Ogni slot va a 4 t/s, ma sono 4 slot: il throughput aggregato è raddoppiato rispetto a
-np 1(12,4 contro 6,3 t/s) e la latenza massima si è dimezzata. Il prezzo è nella prima riga:n_ctx per slot = 512. Con 2048 token di contesto totale e 4 slot, ogni conversazione ha 512 token: una chat di poche battute con un system prompt lungo non ci sta più. -
Tocca il limite. Con il server a
-np 4manda un prompt lungo:python3 -c "print('Riassumi: ' + 'La banda passante della memoria limita la generazione. ' * 120)" > lungo.txt curl -s http://127.0.0.1:8080/v1/chat/completions -H "Content-Type: application/json" \ -d "{\"messages\":[{\"role\":\"user\",\"content\":\"$(cat lungo.txt)\"}],\"max_tokens\":20}"Il prompt (1206 token, contali con
/tokenize) supera i 512 dello slot. Risposta:{"error":{"code":400,"message":"request (1217 tokens) exceeds the available context size (512 tokens), try increasing it", "type":"exceed_context_size_error","n_prompt_tokens":1217,"n_ctx":512}}(1217 = 1206 del testo + 11 del chat template.) Con
-np 1la stessa richiesta passa. -
--kv-unified: riavvia con-np 4 --kv-unifiede guarda il log:Quattro slot, ma ognuno "vede" tutti i 2048 token: il buffer è unico e gli slot attivi se lo spartiscono dinamicamente. Rimanda il prompt lungo del punto 4: ora passa (
finish_reason: length, 20 token di riassunto). Ripeti anchecarico.py:throughput 15.3 t/s, latenza max 8.34 s, in linea con-np 4senza--kv-unified(12,4 t/s: il buffer unico non cambia la velocità di calcolo, cambia solo come si spartisce il contesto). Il costo del buffer unico è che quattro richieste lunghe insieme possono esaurirlo: una richiesta va in coda finché non c'è spazio. -
Ferma il server con Ctrl+C.
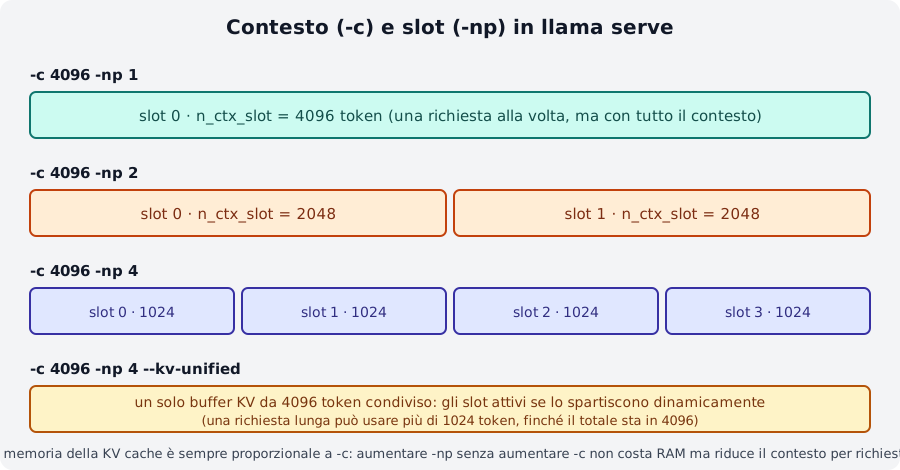
-c 2048: 1 slot da 2048, 2 da 1024 o 4 da 512. Il throughput aggregato sale con gli slot, il contesto per richiesta scende.Verifica del risultato¶
- Hai tre tabelle (
-np 1/2/4) conn_ctx per slot2048 / 1024 / 512. - Con
-np 1ilpicco slot occupatiè 1 e la latenza massima è circa la somma delle quattro; con-np 4le quattro latenze sono quasi uguali. - Il throughput aggregato con
-np 4è maggiore che con-np 1(nelle misure sopra: ×2). - Hai visto il prompt lungo fallire con 4 slot e passare con
--kv-unified.
Domande e varianti¶
- Perché con
-np 4la velocità per slot è più bassa che con-np 1, eppure il totale è più alto? (suggerimento: cosa fallama_decodea ogni passo con 4 sequenze attive? rileggi § 6 del modulo 04). - Prova
--richieste 8 --parallele 8con-np 4: quante restano in coda? Cosa dicellamacpp:requests_deferredse avvii con--metrics? - Prova
--token 128: il vantaggio del batching cresce o cala con risposte più lunghe? - Su GPU la velocità per slot cala molto meno passando da 1 a 4 sequenze (la generazione è limitata dalla banda
di memoria, non dal calcolo: modulo 05). Se ne hai una, rifai le tre misure con
-ngl all. - Quanto contesto totale ti serve per 4 conversazioni da 4096 token ciascuna? Quanta RAM in più costa la KV cache (usa lo stimatore del lab 00-01)?
-np -1(auto, il default) sceglie da solo il numero di slot e attiva--kv-unified: avvia senza-npe leggi cosa ha deciso.
Consegna¶
Un file lab-04-03.md con: le tre uscite di carico.py, una tabella riassuntiva
(np | n_ctx_slot | latenza media | latenza max | throughput), il messaggio d'errore del punto 4 e la risposta
alla prima domanda in cinque righe.