Modulo 06: Output strutturato: grammatiche GBNF e JSON Schema¶
Un modello di linguaggio produce testo libero. Quando quel testo deve essere letto da un programma (un JSON da
decodificare, un comando da eseguire, un "sì/no" da confrontare) il testo libero è un problema: un ```json
di troppo, una virgola mancante, un "2" al posto di 2 e il parser fallisce. llama.cpp risolve il problema
alla radice, nel campionamento: a ogni token una grammatica formale decide quali token sono ammessi e
azzera la probabilità di tutti gli altri. Il modello non può fisicamente uscire dal formato. In questo
modulo impari a scrivere quelle grammatiche (GBNF), a farle generare da un JSON Schema, a usarle via CLI e via
API (response_format) e, soprattutto, a capire che cosa garantiscono e che cosa no.
Cosa imparerai¶
- Come funziona il campionamento vincolato e perché è più affidabile di "per favore rispondi in JSON".
- La sintassi GBNF: regole, terminali, alternanze, ripetizioni, intervalli di caratteri, token speciali.
- Come llama.cpp converte un JSON Schema in grammatica, e quali parti dello schema ignora.
- Come usarlo:
--grammar,--grammar-file,-j/--json-schemanel CLI;grammar,json_schemaeresponse_formatnel server;Custom JSONnella web UI. - I limiti: costo del campionamento, grammatiche lente, valori "inventati" in una forma perfetta, e quando conviene il tool calling al posto della grammatica.
1. Perché vincolare l'output¶
Prova a chiedere a Qwen3.5-0.8B di estrarre dei dati "in JSON" senza vincoli (temperatura 0, thinking spento):
curl -s http://127.0.0.1:8080/v1/chat/completions -H "Content-Type: application/json" -d '{
  "messages": [{"role":"system","content":"Estrai i dati in JSON con i campi nome, eta (intero), citta."},
               {"role":"user","content":"Mi chiamo Giulia Ferri, ho trentaquattro anni e vivo a Ferrara."}],
  "temperature": 0, "max_tokens": 80, "chat_template_kwargs": {"enable_thinking": false}}'
Contenuto della risposta: ```json\n[\n {\n "nome": "Giulia Ferri",\n "eta": 24,\n "citta": "Ferrara"\n }\n]\n```.
Tre problemi in una riga: il blocco Markdown attorno, un array invece di un oggetto, e eta: 24 invece
di 34. Con response_format e uno schema (§ 4) la stessa richiesta restituisce esattamente
{"nome": "Giulia Ferri", "eta": 24, "citta": "Ferrara"}: sparisce la recinzione, sparisce l'array, ma 24
resta 24. Tienilo a mente per tutto il modulo: la grammatica governa la forma, non la verità.
Il meccanismo è nel sampler. A ogni passo il modello produce un logit per ognuno dei ~150k token del
vocabolario; prima che top-k, top-p e temperatura scelgano, la grammatica guarda lo stato in cui si trova
(cosa è già stato generato) e mette a -∞ ogni token che non può proseguire una stringa valida. Il resto è
campionamento normale, rinormalizzato sui token sopravvissuti.
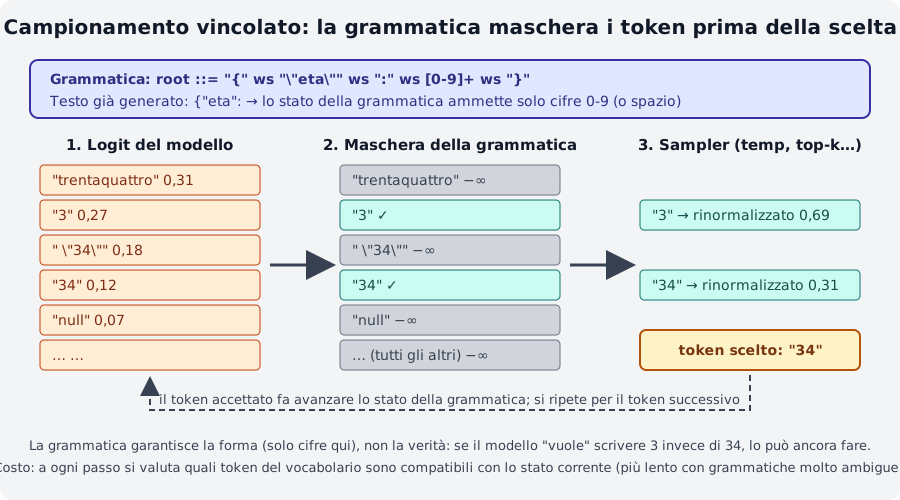
{"eta": la grammatica ammette solo cifre: "trentaquattro" e "null" vengono azzerati, ma fra "3" e "34" sceglie ancora il modello.Il campionamento vincolato è la base di tre funzioni che hai già incontrato o incontrerai: il tool calling del modulo 04 (il server genera una grammatica per il formato di chiamata del modello), lo schema JSON nella web UI e, nel modulo 08, l'estrazione affidabile per un RAG.
2. La sintassi GBNF¶
GBNF (GGML BNF) è una notazione BNF con qualche aggiunta presa dalle espressioni regolari. Una grammatica è un
elenco di regole nome ::= sequenza; la regola root è il punto di partenza e descrive l'intero output.
| Costrutto | Esempio | Significato |
|---|---|---|
| Regola | root ::= "sì" \| "no" |
il nome (minuscolo, con trattini: check-mate) sta per ciò che c'è a destra |
| Terminale | "1. ", "O-O" |
caratteri letterali (Unicode; escape \n, \", \xXX, \uXXXX, \UXXXXXXXX) |
| Intervallo | [1-9], [NBKQR], [ぁ-ゟ] |
un carattere fra quelli elencati |
| Negazione | [^\n]+ |
qualunque carattere tranne quelli elencati |
| Sequenza | "1. " move " " move "\n" |
l'ordine conta |
| Alternanza | pawn \| nonpawn \| castle |
una delle opzioni |
| Gruppo | ("accendi" \| "spegni") " " stanza |
raggruppa per applicare alternanze o ripetizioni |
| Ripetizioni | x* (0+), x+ (1+), x? (0-1), x{3}, x{2,}, x{0,5} |
come nelle regex |
| Token | <think>, <[151667]>, !</think> |
un token del vocabolario (per testo o per id); ! = qualunque altro |
| Commento | # testo |
fino a fine riga |
Le regole possono andare a capo solo dentro parentesi o subito dopo un |: una regola spezzata altrove dà
error parsing grammar: expecting ::= at … (lo incontri scrivendo domotica-json.gbnf nel lab 06-01).
Tre grammatiche di esempio¶
root ::= (
    "1. " move " " move "\n"                    # prima mossa numerata
    ([1-9] [0-9]? ". " move " " move "\n")+     # le successive, con numero a 1-2 cifre
)
move ::= (pawn | nonpawn | castle) [+#]?         # [+#]? = scacco o matto opzionale
pawn ::= ([a-h] "x")? [a-h] [1-8] ("=" [QRBN])?
nonpawn ::= [NBKQR] [a-h]? [1-8]? "x"? [a-h] [1-8]
castle ::= "O-O" ("-O")?
root   ::= object
value  ::= object | array | string | number | ("true" | "false" | "null") ws
object ::= "{" ws ( string ":" ws value ("," ws string ":" ws value)* )? "}" ws
array  ::= "[" ws ( value ("," ws value)* )? "]" ws
string ::= "\"" ( [^"\\\x7F\x00-\x1F] | "\\" (["\\bfnrt] | "u" [0-9a-fA-F]{4}) )* "\"" ws
number ::= ("-"? ([0-9] | [1-9] [0-9]{0,15})) ("." [0-9]+)? ([eE] [-+]? [0-9] [1-9]{0,15})? ws
ws     ::= | " " | "\n" [ \t]{0,20}
Nota ws ::= | " " | …: la prima alternativa è vuota (spazio assente). E nota {0,15} / {0,20} al posto
di *: limitare le ripetizioni tiene la grammatica veloce (§ 5).
Le grammatiche a token servono per i modelli "thinking": root ::= <think> thinking </think> .* con
thinking ::= !</think>* accetta un blocco di ragionamento e poi testo libero; funziona solo se <think> è
un token unico nel vocabolario, altrimenti la grammatica non compila.
Usarla dal CLI¶
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF -st -rea off --temp 0 -n 20 \
  --grammar 'root ::= ("sì" | "no")' -p "Bologna è in Italia? Rispondi sì o no."
# → sì

llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF -st -rea off --temp 0 -n 40 --grammar-file json.gbnf \
  -sys "Estrai citta e gradi in JSON." -p "A Trento oggi ci sono 17 gradi."
Il secondo esempio mostra due cose: il JSON è sintatticamente perfetto ma i nomi dei campi li ha
scelti il modello (city, non citta: la grammatica JSON generica non li conosce), e -n 40 ha tagliato
l'output prima della } finale. Il vincolo non impedisce a max_tokens di troncare: dimensiona sempre il
budget di token e controlla finish_reason. Per un formato di comandi tuo, con vocabolario chiuso, vedi il lab 06-01.
3. Da JSON Schema a grammatica¶
Scrivere a mano una grammatica per un JSON con dieci campi è noioso e fragile. llama.cpp contiene un convertitore
(common/json-schema-to-grammar, riscritto nella 0.4.1 come common_schema) che trasforma un sottoinsieme di
JSON Schema in GBNF, a ogni richiesta. Per lo schema
{"type": "array", "minItems": 10, "maxItems": 100,
 "items": {"type": "object", "additionalProperties": false, "required": ["name", "age"],
           "properties": {"name": {"type": "string", "minLength": 1, "maxLength": 100},
                          "age":  {"type": "integer", "minimum": 0, "maximum": 150}}}}
la grammatica generata (dal README ufficiale) è:
char ::= [^"\\\x7F\x00-\x1F] | [\\] (["\\bfnrt] | "u" [0-9a-fA-F]{4})
item ::= "{" space item-name-kv "," space item-age-kv "}" space
item-age ::= ([0-9] | ([1-8] [0-9] | [9] [0-9]) | "1" ([0-4] [0-9] | [5] "0")) space
item-age-kv ::= "\"age\"" space ":" space item-age
item-name ::= "\"" char{1,100} "\"" space
item-name-kv ::= "\"name\"" space ":" space item-name
root ::= "[" space item ("," space item){9,99} "]" space
space ::= | " " | "\n" [ \t]{0,20}
Leggila con la tabella del § 2: ogni proprietà diventa una regola nome-kv con la chiave letterale (il modello
non può inventare chiavi), le proprietà required compaiono nell'ordine dello schema, minimum/maximum di un
intero diventano un'alternanza di cifre (item-age: da 0 a 150), minLength/maxLength diventano char{1,100},
minItems/maxItems diventano {9,99} ripetizioni dopo il primo elemento.
flowchart TB
    A["JSON Schema<br/>(response_format / json_schema / -j)"] --> B["convertitore<br/>common_schema"]
    B --> C["grammatica GBNF"]
    C --> D["sampler: maschera<br/>a ogni token"]
    E["prompt<br/>(lo schema NON è incluso)"] --> M["modello"]
    M --> D
    D --> F["output valido<br/>rispetto allo schema"]
Lo schema non viene mostrato al modello
Lo schema vincola soltanto il campionamento, non è iniettato nel prompt. Il modello "scopre" la struttura
token per token, mentre la grammatica gli chiude le strade. Se vuoi che capisca cosa deve scrivere in ogni
campo (cosa vuol dire locali, che prezzo_euro è un intero senza separatori) descrivilo tu nel prompt.
Con il tool calling è diverso: lì lo schema dei parametri finisce nel prompt tramite il chat template.
Cosa il convertitore supporta e cosa no (README grammars/, build corrente):
| Supportato | Non supportato o limitato |
|---|---|
type (object, array, string, integer, number, boolean, null), enum, const |
additionalProperties è false di default (contrario alla specifica: più veloce, meno allucinazioni); true può produrre chiavi con newline non escapate |
properties, required, items, minItems/maxItems |
prefixItems rotto; uniqueItems, contains/minContains mai |
minLength/maxLength, pattern (deve iniziare con ^ e finire con $) |
patternProperties no; format senza uri ed email (date, time, date-time, uuid sì) |
minimum, maximum, exclusiveMinimum/Maximum solo per integer |
per number gli estremi sono ignorati |
anyOf, oneOf, allOf, $ref locali, $defs |
non si può mescolare properties con anyOf/oneOf nello stesso tipo; $ref annidati rotti; $ref remoti no (solo le versioni Python/JS) |
not, if/then/else, dependentSchemas, $anchor |
Le feature non supportate sono ignorate in silenzio: lo schema viene accettato, la grammatica semplicemente non
le fa rispettare. Se ti servono, valida il risultato nel client (un jsonschema.validate in Python) oltre alla grammatica.
4. Nell'API e nel CLI¶
| Dove | Come |
|---|---|
llama cli / llama completion |
--grammar 'root ::= …', --grammar-file f.gbnf, -j '{"type":"object"}', -jf schema.json |
POST /completion (nativo) |
campo grammar (stringa GBNF) oppure json_schema (oggetto) |
POST /v1/chat/completions |
response_format (sotto) oppure gli stessi grammar / json_schema di /completion |
| Web UI | Settings → Developer → Custom JSON → {"json_schema": {…}} (lab 04-01) |
| Tool calling | automatico: il server genera la grammatica dal formato del modello e dai parameters dei tool |
response_format accetta le due forme OpenAI, più una variante:
{"type": "json_object"}                                         // JSON qualsiasi (grammatica json generica)
{"type": "json_object", "schema": {…}}                          // variante llama.cpp: json_object + schema
{"type": "json_schema", "schema": {…}}                          // forma della doc llama.app
{"type": "json_schema", "json_schema": {"name": "x", "schema": {…}}}   // forma OpenAI (quella che l'SDK produce)
Richiesta con schema (stesso prompt del § 1):
curl -s http://127.0.0.1:8080/v1/chat/completions -H "Content-Type: application/json" -d '{
  "messages": [{"role":"system","content":"Estrai i dati in JSON con i campi nome, eta (intero), citta."},
               {"role":"user","content":"Mi chiamo Giulia Ferri, ho trentaquattro anni e vivo a Ferrara."}],
  "temperature": 0, "max_tokens": 80, "chat_template_kwargs": {"enable_thinking": false},
  "response_format": {"type": "json_schema", "schema": {"type": "object",
     "properties": {"nome": {"type": "string"}, "eta": {"type": "integer", "minimum": 0, "maximum": 120},
                    "citta": {"type": "string"}}, "required": ["nome", "eta", "citta"]}}}'
{"choices":[{"finish_reason":"stop","message":{"role":"assistant","content":"{\n  \"nome\": \"Giulia Ferri\",\n  \"eta\": 24,\n  \"citta\": \"Ferrara\"\n}"}}],
 "usage":{"prompt_tokens":53,"completion_tokens":34}, "timings":{"predicted_per_second":8.5,"…":"…"}}
Con {"type": "json_object"} e la domanda «Dammi nome, eta e citta di un personaggio inventato, in JSON» il modello
ha risposto {"nome": "Elio", "citta": "Milano"}: JSON valido, ma senza eta. json_object garantisce solo
"un JSON": per i campi obbligatori serve lo schema.
Con l'SDK Python (lab 06-02 usa la libreria standard, ma il principio è lo stesso):
r = client.chat.completions.create(model="local", messages=msgs,
    response_format={"type": "json_schema", "json_schema": {"name": "persona", "schema": SCHEMA}},
    extra_body={"chat_template_kwargs": {"enable_thinking": False}})
dati = json.loads(r.choices[0].message.content)
Sul CLI, -j e -jf sono documentati per llama cli, ma sulla build b11046 falliscono con
Error: Failed to initialize samplers: std::exception con qualunque schema, anche {"type":"object"},
sia con il binario dell'installer sia con llama-cli del tarball. Funziona invece llama completion -j …
(risposta: {"citta": "Trento", "gradi": 17}), e in chat resta --grammar-file con una grammatica JSON.
Se vuoi lo schema in una sessione interattiva usa il server.
Una grammatica malformata è un errore di richiesta, non di generazione:
{"error":{"code":400,"message":"Failed to initialize samplers: failed to parse grammar","type":"invalid_request_error"}}
5. Limiti e costi¶
La forma non è la verità. Nel lab 06-02, con uno schema rigoroso, tre annunci immobiliari su tre producono JSON
validi: ma un "trilocale" diventa locali: 2, una villa diventa tipo: "appartamento" e ascensore: true compare
dove il testo non lo cita. La grammatica ha chiuso le strade sintattiche; dentro il campo, il modello sceglie fra
i valori ammessi con la sua (poca) competenza. Un enum con quattro valori obbliga a sceglierne uno anche quando
nessuno è giusto: prevedi sempre un'uscita ("altro", null) e controlla i valori a valle.
Il modello può essere costretto in un vicolo cieco. Una grammatica che parte con { vieta al modello di
iniziare con Ecco il JSON: (bene) ma anche con il blocco <think> dei modelli "thinking", che così ragionano
"dentro" il JSON o producono risultati peggiori. Negli esempi di questo modulo il thinking è spento
(enable_thinking: false, -rea off); se ti serve il ragionamento, usa una grammatica a token che lo ammetta
(§ 2) e controlla il comportamento con il tuo modello: ogni famiglia usa token di ragionamento diversi.
Costo. A ogni token il sampler deve stabilire quali dei ~150k token del vocabolario sono compatibili con lo stato della grammatica; con grammatiche ambigue (molti percorsi possibili aperti insieme) l'insieme degli stati esplode. Le regole d'oro del README ufficiale:
- Ripetizioni limitate:
x{0,N}e nonx? x? x? …néx*su spazi bianchi (lowsdijson.gbnfusa[ \t]{0,20}; il lab 06-01 usa[ \n]{0,4}). - Meno alternanze aperte possibile;
additionalProperties: false(il default) tiene la grammatica piccola. - Con il thinking spento e temperatura 0, su uno schema di tre campi il vincolo non rallenta la generazione in modo misurabile: su una macchina a 6 vCPU senza GPU, 8,5 t/s con schema e 4,9 senza, una differenza che rientra nella variabilità delle misure su CPU, non nel costo del sampler. Diventa un costo con schemi di decine di campi annidati e stringhe lunghe.
Diagnostica. Il server rifiuta con 400 le grammatiche che non compilano; le feature dello schema non supportate
invece passano senza avviso. Per capire cosa è stato generato davvero puoi convertire lo schema con lo script
examples/json_schema_to_grammar.py dei sorgenti (stampa la GBNF) e provare la grammatica con
tests/test-gbnf-validator compilato dai sorgenti (non è nei tarball delle release).
Grammatica o tool calling?¶
| Vuoi… | Usa |
|---|---|
| un output in un formato tuo, non JSON (comandi, CSV, mosse, "sì/no") | grammar GBNF |
| un JSON che rispetti uno schema, senza logica di programma nel mezzo | response_format / json_schema |
| che il modello decida se e quale funzione chiamare, con argomenti validi, e poi continui con il risultato | tool calling (modulo 04): lo schema dei parametri finisce nel prompt, il formato di chiamata è quello nativo del modello |
| che il modello risponda a testo oppure in JSON, a seconda del caso | tool calling (tool_choice: auto): una grammatica JSON obbligherebbe sempre il JSON |
| garanzie sul contenuto (numeri corretti, categorie giuste) | nessuno dei due: validazione a valle, modelli più grandi, esempi nel prompt |
Riepilogo¶
| Concetto | Dove |
|---|---|
| Grammatica GBNF | regole nome ::= …, root obbligatoria; terminali, [a-z], \|, (), * + ? {m,n}, <token> |
| Nel CLI | --grammar, --grammar-file; -j/-jf (su b11046 solo in llama completion) |
| Nel server | grammar, json_schema (nativi); response_format: json_object \| json_schema (OpenAI) |
| Schema → grammatica | sottoinsieme di JSON Schema; additionalProperties: false di default; schema non nel prompt |
| Limiti | forma sì, verità no; feature ignorate in silenzio; ripetizioni illimitate lente; thinking vs { |
| Alternativa | tool calling quando la scelta dell'azione spetta al modello |
Errori comuni¶
expecting ::= at …
Hai spezzato una regola su più righe fuori dalle parentesi. Metti la parte destra fra ( … ) oppure vai a
capo subito dopo un |.
Il JSON è valido ma i campi si chiamano in un altro modo
Hai usato json_object o una grammatica JSON generica: le chiavi le sceglie il modello. Passa uno schema con
properties + required, e descrivi i campi nel prompt (lo schema non lo vede).
Output tagliato a metà
finish_reason: length. La grammatica non può chiudere le parentesi al posto del modello se i token finiscono.
Alza max_tokens e limita maxLength/maxItems nello schema.
Con la grammatica il modello 'thinking' produce spazzatura o si blocca
La grammatica vieta <think> come primo token. Spegni il thinking o scrivi una grammatica a token che lo ammetta.
minimum/maximum ignorati
Valgono solo per integer. Per i number (e per tutte le feature della tabella "non supportato") valida nel client.
llama cli -j → Failed to initialize samplers
Bug della build b11046: usa llama completion -j, --grammar-file, o il server con json_schema.
Laboratori di questo modulo¶
- Lab 06-01: Scrivere una grammatica: una grammatica GBNF per comandi
domotici, in forma testuale e in forma JSON, provata con
llama cli --grammar-filee via API. - Lab 06-02: Estrazione dati in JSON:
response_formatcon schema su annunci immobiliari, confronto con/senza vincolo, e caccia agli errori nei valori.
Verifica¶
- Dove agisce esattamente una grammatica GBNF nel processo di generazione? Cosa fa ai token non ammessi?
- Scrivi una regola GBNF che accetti un orario
HH:MMcon ore 00-23 e minuti 00-59. - Perché
ws ::= [ \t\n]*è sconsigliato e cosa usare al suo posto? - Il modello riceve lo schema JSON passato in
response_format? E iparametersdi un tool? - Qual è il default di
additionalPropertiesin llama.cpp e perché è diverso dalla specifica? - Uno schema con
"type": "number", "minimum": 0può produrre-3.5? Perché? - Estrai
etada «ho trentaquattro anni» con uno schemainteger: il risultato è garantito 34? - Devi far scegliere al modello se cercare nel database o rispondere subito: grammatica o tool calling?
Soluzioni
- Nel sampler, prima di top-k/top-p/temperatura: a ogni passo maschera (logit
-∞) i token che non possono continuare una stringa valida dallo stato corrente; il token scelto fa avanzare lo stato. root ::= ([01] [0-9] | "2" [0-3]) ":" [0-5] [0-9]- Le ripetizioni illimitate su alternative "aperte" moltiplicano gli stati da valutare a ogni token. Meglio
una ripetizione limitata:
ws ::= [ \t\n]{0,20}(o le forme dijson.gbnf:| " " | "\n" [ \t]{0,20}). - No:
response_format/json_schemavincolano solo il campionamento, il prompt non cambia. Sì per i tool: il chat template inserisce nome, descrizione e schema dei parametri nel prompt. false: grammatica più piccola e veloce, meno chiavi allucinate. La specifica JSON Schema dicetrue.- Sì:
minimum/maximumsono applicati solo ainteger; pernumbervengono ignorati in silenzio. - No. La grammatica garantisce che sia un intero (nell'intervallo, se indicato); il valore lo sceglie il modello, che può sbagliare (nell'esempio del § 1: 24). Serve validazione a valle o un modello migliore.
- Tool calling con
tool_choice: auto: il modello può rispondere a testo o emettere unatool_callcon argomenti già validi. Una grammatica JSON lo obbligherebbe sempre al JSON.
Riferimenti¶
- grammars/README.md: guida GBNF, conversione da JSON Schema, limiti
- grammars/: esempi
json.gbnf,json_arr.gbnf,chess.gbnf,list.gbnf,arithmetic.gbnf,c.gbnf - tools/server/README.md: campi
grammar,json_schema,response_format - llama.app: API server: esempio di
response_format - tests/test-json-schema-to-grammar.cpp: l'elenco più aggiornato delle feature di schema supportate
- Issue 4218: prestazioni delle grammatiche
- JSON Schema: riferimento della specifica